Data Science with Python — CCPP case
Un caso práctico de análisis exploratorio de datos con pandas y matplotlib: explorar la relación entre variables ambientales y la potencia eléctrica generada por una Combined Cycle Power Plant (central de ciclo combinado).
El dataset es de libre acceso en UCI Machine Learning Repository — contiene 9,568 observaciones recolectadas durante 6 años de operación de una planta real:
https://archive.ics.uci.edu/ml/datasets/Combined+Cycle+Power+Plant
Las variables disponibles son:
- AT — Temperatura ambiente (°C)
- V — Vacío de escape (cm Hg)
- AP — Presión ambiente (hPa)
- RH — Humedad relativa (%)
- EP — Salida horaria neta de energía eléctrica (MW)
El objetivo es cuantificar cómo la presión ambiente (AP) influye sobre la potencia generada (EP).
import pandas as pd
import matplotlib.pyplot as plt

#Importing the dataset
dataset = pd.read_excel("Combined_Cycle_Power_Plant_Data_Set.xlsx")
print(f"Showing the header of the dataset: \n {dataset.head()}")

#Plotting AP and EP data
plt.scatter(dataset['AP'], dataset['EP'])
plt.xlabel('Ambient Pressure (AP)')
plt.ylabel('Net Hourly Electrical Energy Output (EP)')
plt.title('Relationship between AP and EP')
plt.show()

#Calculating the correlation between AP and EP
correlation = dataset['EP'].corr(dataset['AP'])
print(f"The correlation between AP and EP is: {correlation:.4f}")
La salida numérica:
The correlation between AP and EP is: 0.5185
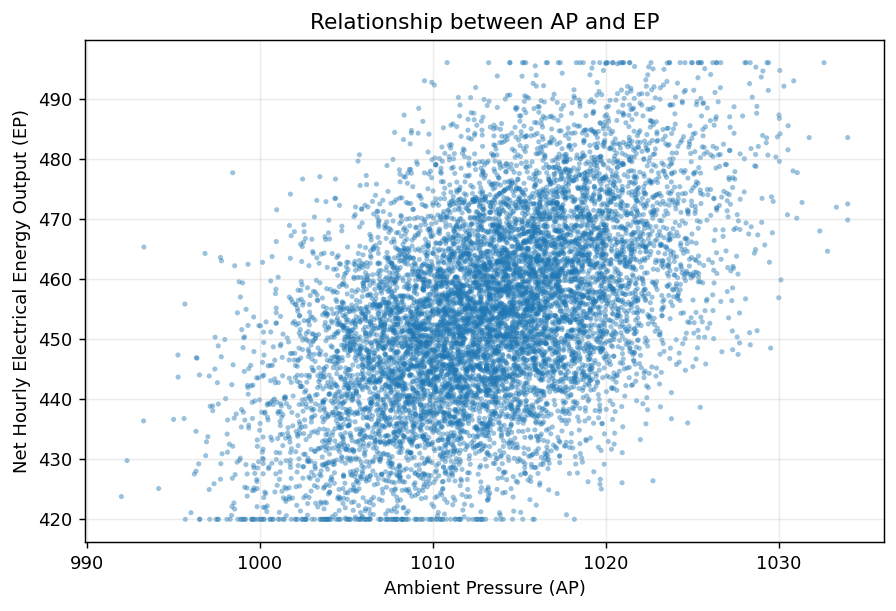
La correlación de Pearson entre AP y EP es de aproximadamente \(r \approx 0.52\) — relación positiva moderada. Matemáticamente:
Interpretación física: cuando la presión ambiente sube, la densidad del aire aumenta, mejora el flujo másico de aire en la turbina de gas y la planta entrega más potencia. La correlación no es perfecta porque AT (temperatura) y V (vacío del condensador) tienen mucha más influencia sobre EP (\(r_{AT,EP} \approx -0.95\)).
Próximos pasos típicos:
- Matriz de correlaciones completa (
dataset.corr()) + heatmap con seaborn - Ajuste de un modelo lineal multivariable (
sklearn.linear_model.LinearRegression) usando AT, V, AP, RH como predictores - Evaluación con \(R^2\) y RMSE sobre un split train/test
Instalación:
pip install pandas matplotlib openpyxl