Gradient Descent with Python
El descenso por gradiente es el motor detrás del entrenamiento de casi toda red neuronal moderna. La idea es sorprendentemente simple: desplazarse iterativamente en la dirección opuesta al gradiente de la función objetivo para bajar "cuesta abajo" hasta un mínimo.
En cada paso:
donde \(\eta\) es el learning rate o tamaño de paso. Si es muy pequeño, converge lento; si es muy grande, puede oscilar o divergir.
Para ilustrarlo, minimicemos \(f(x) = x^2 + 2x - 4\). El mínimo analítico está en \(x^* = -1\) con \(f(x^*) = -5\).
#Function to be minimized
def f(x):
    return x**2 + 2*x - 4

#Derivative of the function
def df(x):
    return 2*x + 2

#Beginning of the Gradient Descent algorithm
#===========================================

#Initial parameters
x0 = 2
learning_rate = 0.1
iterations = 100

for i in range(iterations):
    x0 = x0 - learning_rate*df(x0)

#Showing the final value of x0 and f(x0)
print(f"Value of x0: {x0:.4f}")
print(f"Minimum value of f(x): {f(x0):.4f}")
Ejecutándolo obtenemos:
Value of x0: -1.0000
Minimum value of f(x): -5.0000
El método converge al mínimo real en prácticamente las primeras 20 iteraciones:
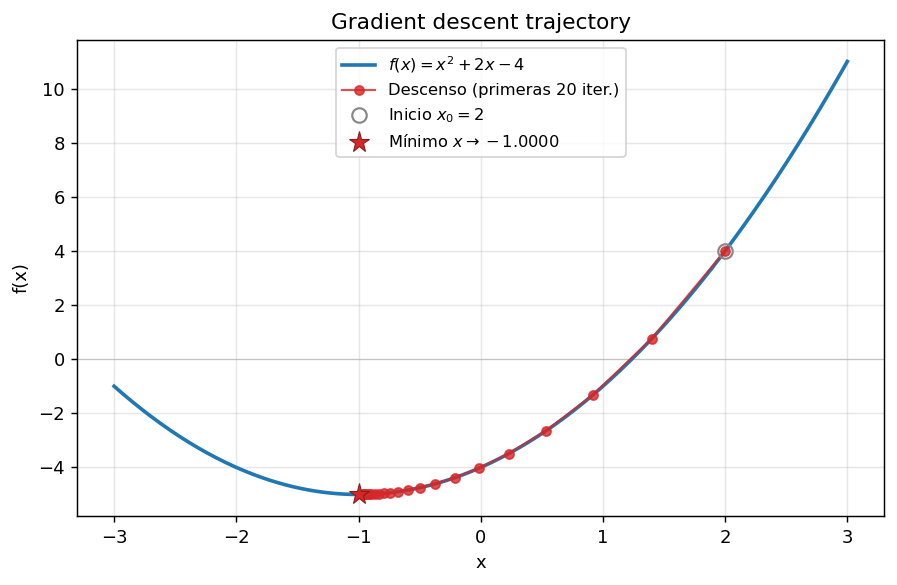
Cada paso divide la distancia al óptimo por un factor de \((1 - 2\eta) = 0.8\) (porque aquí \(f''(x) = 2\) es constante). A este tipo de convergencia se le llama lineal — exponencialmente rápida en teoría, pero en problemas reales con múltiples mínimos locales la trayectoria puede quedarse atrapada.
De 1D a aprendizaje profundo:
La misma idea se generaliza a vectores: \(\vec{w}_{n+1} = \vec{w}_n - \eta \cdot \nabla L(\vec{w}_n)\), donde \(\vec{w}\) son los pesos de la red y \(L\) es la función de pérdida. En la práctica se usan variantes como:
- SGD con momentum — acelera en direcciones consistentes
- Adam / RMSprop — ajustan \(\eta\) individualmente por parámetro
- Mini-batch — estima \(\nabla L\) sobre un subconjunto aleatorio del dataset
Instalación:
No requiere librerías — Python estándar basta. Para problemas más grandes:
pip install numpy